动态追踪技术
概述
是什么
面临着两大方面的挑战:
- 一是规模,不管是用户规模还是机房的规模、机器的数量都处于快速增长的时代。
- 第二方面的挑战就是复杂度。我们的业务逻辑越来越复杂,我们运行的软件系统也变得越来越复杂,我们知道它会分成很多很多层次,
动态追踪技术允许我们使用非侵入式的方式,不用去修改我们的操作系统内核,不用去修改我们的应用程序,也不用去修改我们的业务代码或者任何配置,就可以快速高效地精确获取我们想要的信息,第一手的信息,从而帮助定位我们正在排查的各种问题。
优点
- 各种基于动态追踪的分析工具的运行方式都是一种“热插拔”的方式,就是说,我们随时可以运行这个工具,随时进行采样,随时结束采样,而不用管目标系统的当前状态
- 它自身的性能损耗极小。仔细写出的调试工具对系统的极限性能的影响,通常在百分之五,甚至更低的比例以下,所以它一般不会对我们的最终用户产生可以观察到的性能影响。另外,即使是这么小的性能损耗也只发生在我们实际采样的那几十秒或者几分钟以内。一旦我们的调试工具结束运行,在线系统又会自动恢复到原先百分之百的性能,继续向前狂奔。
Dtrace
History
当时 Solaris 操作系统的几个工程师花了几天几夜去排查一个看似非常诡异的线上问题。 开始他们以为是很高级的问题,就特别卖力,结果折腾了几天,最后发现其实是一个非常愚蠢的、某个不起眼的地方的配置问题。 自从那件事情之后,这些工程师就痛定思痛,创造了 DTrace 这样一个非常高级的调试工具,来帮助他们在未来的工作当中避免把过多精力花费在愚蠢问题上面。 毕竟大部分所谓的“诡异问题”其实都是低级问题,属于那种“调不出来很郁闷,调出来了更郁闷”的类型。---《漫谈动态追踪技术》
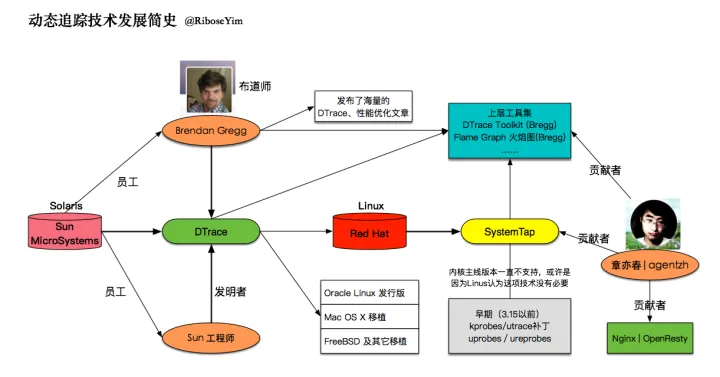
Brendan Gregg: 布兰登 格雷格
SystemTap
- SystemTap 的优点是它有非常成熟的用户态调试符号的自动加载
- 同时也有循环这样的语言结构可以去编写比较复杂的探针处理程序,可以支持很多很复杂的分析处理。
缺点
- SystemTap 脚本的启动相比 DTrace 要慢得多,和 JVM 的启动时间倒有几分类似
- 它通常是把它的“小语言”脚本(有点像 D 语言哦)动态编译成一个 Linux 内核模块的 C 源码,因此经常需要在线部署 C 编译器工具链和 Linux 内核的头文件
- 它并不是 Linux 内核的一部分,就是说它并没有与内核紧密集成,所以它需要一直不停地追赶主线内核的变化
例子
第一个例子是,我使用基于 SystemTap 的火焰图工具分析我们线上的 Nginx 进程,结果发现有相当一部分 CPU 时间花费在了一条非常奇怪的代码路径上面。这其实是我一位同事在很久之前调试一个老问题时遗留下来的临时的调试代码,有点儿像我们前面提到的“埋点代码”。结果它就这样被遗忘在了线上,遗忘在了公司代码仓库里,虽然当时那个问题其实早已解决。由于这个代价高昂的“埋点代码”一直没有去除,所以一直都产生着较大的性能损耗,而一直都没有人注意到。所以可谓是我意外的发现。当时我就是通过采样的方式,让工具自动绘制出一张火焰图。我一看这张图就可以发现问题并能采取措施。这是非常非常有效的方式。
第二个例子是,很少量的请求存在延时较长的问题,即所谓的“长尾请求”。这些请求数目很低,但可能达到「秒级」这样的延时。当时有同事乱猜说是我的 OpenResty 有 bug,我不服气,于是立即编写了一个 SystemTap 工具去在线进行采样,对那些超过一秒总延时的请求进行分析。该工具会直接测试这些问题请求内部的时间分布,包括请求处理过程中各个典型 I/O 操作的延时以及纯 CPU 计算延时。结果很快定位到是 OpenResty 在访问 Go 编写的 DNS 服务器时,出现延时缓慢。然后我再让我的工具输出这些长尾 DNS 查询的具体内容,发现都是涉及 CNAME 展开。显然,这与 OpenResty 无关了,而进一步的排查和优化也有了明确的方向。
第三个例子是,我们曾注意到某一个机房的机器存在比例明显高于其他机房的网络超时的问题,但也只有 1% 的比例。一开始我们很自然的去怀疑网络协议栈方面的细节。但后来我通过一系列专门的 SystemTap 工具直接分析那些超时请求的内部细节,便定位到了是硬盘 配置方面的问题。从网络到硬盘,这种调试是非常有趣的。第一手的数据让我们快速走上正确的轨道。
还有一个例子是,我们曾经通过火焰图在 Nginx 进程里观察到文件的打开和关闭操作占用了较多的 CPU 时间,于是我们很自然地启用了 Nginx 自身的文件句柄缓存配置,但是优化效果并不明显。于是再做出一张新的火焰图,便发现因为这回轮到 Nginx 的文件句柄缓存的元数据所使用的“自旋锁”占用很多 CPU 时间了。这是因为我们虽然启用了缓存,但把缓存的大小设置得过大,所以导致元数据的自旋锁的开销抵消掉了缓存带来的好处。这一切都能在火焰图上面一目了然地看出来。假设我们没有火焰图,而只是盲目地试验,很可能会得出 Nginx 的文件句柄缓存没用的错误结论,而不会去想到去调整缓存的参数。
最后一个例子是,我们在某一次上线操作之后,在线上最新的火焰图中观察到正则表达式的编译操作占用了很多 CPU 时间,但其实我们已经在线上启用了正则编译结果的缓存。很显然,我们业务系统中用到的正则表达式的数量,已然超出了我们最初设置的缓存大小,于是很自然地想到把线上的正则缓存调的更大一些。然后,我们在线上的火焰图中便再看不到正则编译操作了。
方法论
前面我们介绍到火焰图这样的基于采样的可视化方法,它其实算是非常通用的方法了。不管是什么系统,是用什么语言编写的,我们一般都可以得到一张某种性能维度上的火焰图,然后轻松进行分析。但更多的时候,我们可能需要对一些更深层次的更特殊的问题进行分析和排查,此时就需要编写一系列专门化的动态追踪工具,有计划有步骤地去逼近真正的问题。
在这个过程当中,我们推荐的策略是一种所谓的小步推进、连续求问的方式。也就是说我们并不指望一下编写一个很庞大很复杂的调试工具,一下子采集到所有可能需要的信息,从而一下子解决掉最终的问题。相反,我们会把最终问题的假设,分解成一系列的小假设,然后逐步求索,逐步验证,不断确定会修正我们的方向,不断地调整我们的轨迹和我们的假设,以接近最终的问题。这样做有一个好处是,每一个步骤每一个阶段的工具都可以足够的简单,那么这些工具本身犯错的可能性就大大降低。Brendan 也注意到他如果尝试编写多用途的复杂工具,这种复杂工具本身引入 bug 的可能性也大大提高了。而错误的工具会给出错误的信息,从而误导我们得出错误的结论。这是非常危险的。简单工具的另一大好处是,在采样过程当中对生产系统产生的开销也会相对较小,毕竟引入的探针数目较少,每个探针的处理程序也不会有太多太复杂的计算。这里的每一个调试工具都有自己的针对性,都可以单独使用,那么这些工具在未来得到复用的机会也大大提高。所以总的来说,这种调试策略是非常有益的。
值得一提的是,这里我们拒绝所谓的“大数据”的调试做法。即我们并不会去尝试一下子采集尽可能全的信息和数据。相反,我们在每一个阶段每一个步骤上只采集我们当前步骤真正需要的信息。在每一步上,基于我们已经采集到的信息,去支持或者修正我们原来的方案和原来的方向,然后去指导编写下一步更细化的分析工具。
另外,对于非常小频率发生的线上事件,我们通常会采用“守株待兔”的做法,也就是说我们会设一个阈值或其他筛选条件,坐等有趣的事件被我们的探针捕获到。比如在追踪小频率的大延时请求的时候,我们会在调试工具里,首先筛选出那些延时超过一定阈值的请求,然后针对这些请求,采集尽可能多的实际需要的细节信息。这种策略其实跟我们传统的尽可能多的采集全量统计数据的做法完全相反,正因为我们是有针对性地、有具体策略地进行采样分析,我们才能把损耗和开销降到最低点,避免无谓的资源浪费。
我们的 OpenResty XRay 产品通过知识库和推理引擎,可以自动化应用各种动态追踪方面的方法论,可以自动使用系统性的方法,逐步缩小问题范围,直至定位问题根源,再报告给用户,并向用户建议优化或修复方法。
死亡进程的遗骸分析
我们前面看到的其实都是对活着的进程进行分析,或者说正在运行的程序。那么死的进程呢?对于死掉的进程,其实最常见的形式就是进程发生了异常崩溃,产生了所谓**的 core dump 文件。**其实对于这样死掉的进程剩下的“遗骸”,我们也可以进行很多深入的分析,从而有可能确定它的死亡原因。从这个意义上来讲,我们作为程序员扮演着「法医」这样的角色。
最经典的针对死进程遗骸进行分析的工具便是鼎鼎大名的** GNU Debugger(GDB)。那么 LLVM 世界也有一个类似的工具叫做 **LLDB。显然,GDB 原生的命令语言是非常有局限的,我们如果手工逐条命令地对 core dump 进行分析其实能得到地信息也非常有限。其实大部分工程师分析 core dump 也只是用 bt full 命令查看一下当前的 C 调用栈轨迹,抑或是利用 info reg 命令查看一下各个 CPU 寄存器的当前取值,又或者查看一下崩溃位置的机器代码序列,等等。而其实更多的信息深藏于在堆(heap)中分配的各种复杂的二进制数据结构之中。对堆里的复杂数据结构进行扫描和分析,显然需要自动化,我们需要一种可编程的方式来编写复杂的 core dump 的分析工具。
顺应此需求,GDB 在较新的版本当中(我记得好像是从 7.0 开始的),内置了对 Python 脚本的支持。我们现在可以用 Python 来实现较复杂的 GDB 命令,从而对 core dump 这样的东西进行深度分析。事实上我也用 Python 写了很多这样的基于 GDB 的高级调试工具,甚至很多工具是和分析活体进程的 SystemTap 工具一一对应起来的。与动态追踪类似,借助于调试符号,我们可以在黑暗的“死亡世界”中找到光明之路。